« La dernière IA construite par les humains » : ce que révèle vraiment le papier sur l'autonomie des IA
« La dernière IA construite par les humains » : publié le 10 septembre 2026 sur arXiv, un papier cosigné par 33 chercheurs chinois définit l'amélioration récursive (RSI) en cinq niveaux d'autonomie et mesure la progression des capacités avec un indice, le HCI. Son constat : les systèmes actuels plafonnent entre les niveaux 1 et 2, la boucle d'auto-amélioration ne se referme pas encore.
Ce que dit le papier : une vision, pas un produit
Le papier s'intitule « The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement » (arXiv 2609.11873, catégorie cs.LG). Il émane de 33 chercheurs affiliés à l'Université Jiao Tong de Shanghai, l'Université Tsinghua, ByteDance Seed, Xiaohongshu, Agent-NativeLab et le Shanghai AI Lab ; l'auteur correspondant est Xuanhe Zhou. La page projet accompagne la publication.
Le titre est une ambition rhétorique, pas l'annonce d'un système existant. L'idée sous-jacente : si une IA parvenait un jour à s'améliorer elle-même de façon autonome et fiable, elle serait en un sens la dernière que les humains auraient besoin de construire. Les générations suivantes découleraient de son propre travail. C'est une vision, un horizon, pas un constat.
Le contenu réel est plus prosaïque et plus utile. Les auteurs définissent précisément l'amélioration récursive (en anglais recursive self-improvement, ou RSI) : un processus autonome en boucle fermée où un système d'IA identifie ses propres limites, développe et valide des améliorations, puis utilise les capacités acquises pour améliorer le processus d'amélioration lui-même. Ils proposent ensuite une grille de lecture en cinq niveaux d'autonomie, examinent les systèmes existants à cette aune et dressent le constat central : les systèmes actuels n'atteignent au mieux que des niveaux partiels, et la RSI authentique reste à construire.
Autrement dit, loin de célébrer l'arrivée d'une IA qui s'améliore toute seule, l'étude mesure l'écart entre le rêve et la réalité technique.
Les cinq niveaux d'autonomie : le cœur du papier
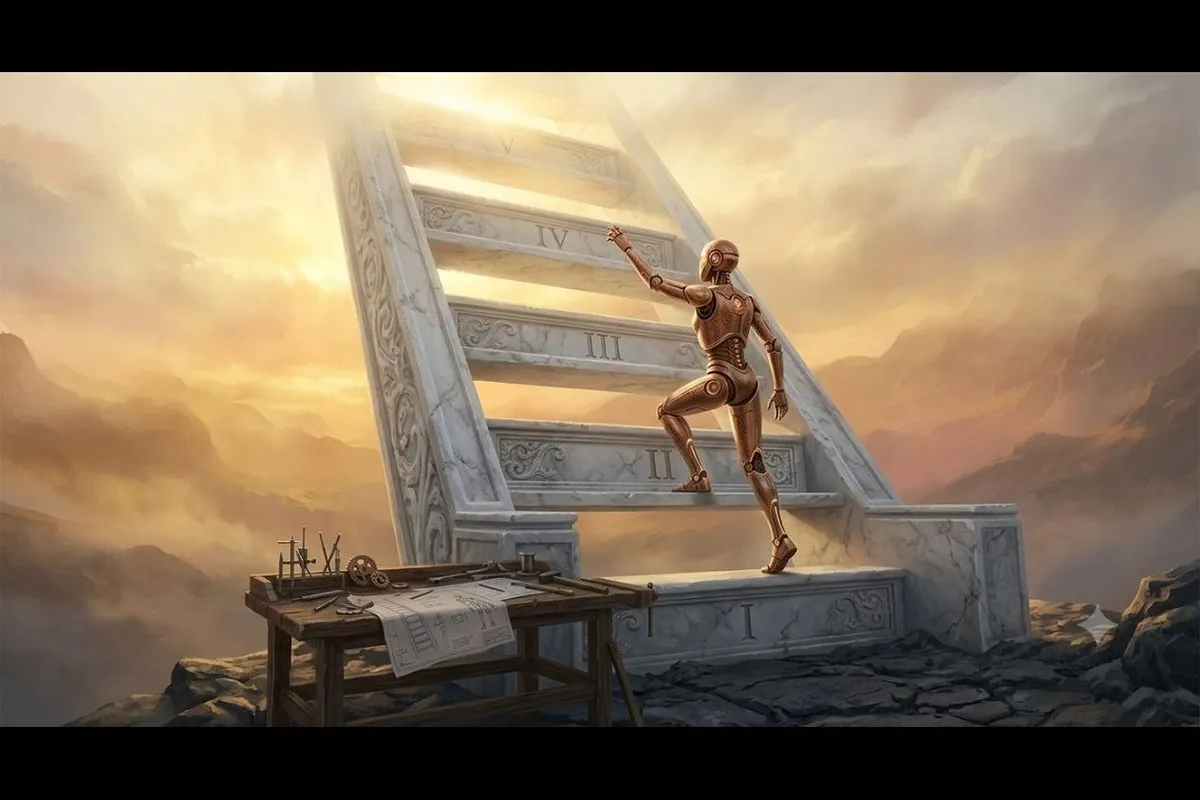
La contribution la plus utile du papier est cette échelle à cinq niveaux, qui décrit qui décide quoi dans la boucle d'amélioration d'un système d'IA. Imaginez un cuisinier dont on élargit progressivement le périmètre : d'abord simple exécutant d'une recette, puis choix des techniques, puis de ses propres ingrédients, puis adaptation au retour des clients, et enfin révision de sa propre méthode de travail.
- L1, exécuter des améliorations prescrites. Les humains spécifient quoi améliorer, comment, et ce qu'est un succès. L'IA ne fait qu'appliquer. C'est l'ouvrier qui assemble une pièce selon un plan qu'il n'a pas conçu.
- L2, choisir ses stratégies d'amélioration. L'objectif et les critères d'évaluation restent fixés de l'extérieur, mais l'IA diagnostique ses faiblesses et décide comment s'améliorer. Elle choisit son itinéraire, pas sa destination.
- L3, acquérir sa future expérience d'apprentissage. Le système détermine aussi l'expérience dont il aura besoin pour progresser : il génère ses propres exercices, choisit ses tâches d'entraînement, se fabrique son curriculum. Il ne se contente plus de choisir comment étudier : il décide quoi étudier.
- L4, s'adapter via le déploiement et le retour de l'environnement. Le système apprend en continu de ce qui lui arrive une fois déployé : il observe les conséquences de ses actions dans le monde réel et en fait un état persistant qui profite aux interactions suivantes.
- L5, améliorer les mécanismes qui gouvernent l'amélioration suivante. C'est la méta-amélioration, le cœur de la RSI authentique : le système révise la méthode même par laquelle il produit et valide ses futures versions, comme un chercheur qui repenserait sa propre démarche scientifique.
La force de cette grille est de dissocier deux choses souvent confondues : la performance d'un système et son autonomie d'amélioration. Un modèle peut être excellent aux tests tout en étant incapable d'organiser le moindre cycle d'auto-amélioration. C'est exactement ce que montrent les données.
Où on en est : entre L1 et L2, pas au-delà
Le papier examine plusieurs systèmes souvent cités comme des preuves d'IA qui s'améliore seule, et montre qu'aucun ne franchit réellement le seuil.
Le Darwin Gödel Machine fait passer un agent de programmation de 20 à 50 pour cent de réussite sur un sous-ensemble de SWE-bench, un benchmark de génie logiciel. Progression impressionnante, mais l'analyse est sans appel : la sélection des parents et la gestion de l'archive des variantes restent hors de l'auto-modification. La machine ne modifie pas les règles selon lesquelles elle évolue.
AlphaEvolve, de Google DeepMind, automatise une recherche de programmes qui génère, mute et évalue des candidats, mais reste dans un cadre où l'objectif et les critères sont fixés de l'extérieur. AlphaChip optimise des placements de puces en apprenant d'un projet à l'autre, sans reprendre à son compte la gouvernance du processus. L'AI Co-Scientist génère, débat et classe des hypothèses scientifiques, sans que le système améliore sa propre méthode d'amélioration.
Le monde industriel raconte la même histoire, avec une nuance importante : l'amélioration de la chaîne de développement par l'IA elle-même est déjà bien réelle, simplement elle reste bornée aux niveaux L1 et L2. OpenAI rapporte qu'au cours des six mois précédant GPT-5.6, la part du compute de recherche dédiée à l'inférence de codage interne a été multipliée par 100 et l'usage agentique interne par 22. Les modèles récents atteignent des tailles considérables, avec 2 800 milliards de paramètres chez Moonshot (Kimi K3) et 2 400 milliards chez Alibaba (Qwen3.8-Max), et des contextes d'environ un million de tokens. Les laboratoires délèguent massivement l'exécution et une part du diagnostic à des outils d'IA, mais les décisions de fond, objectifs, critères d'acceptation, supervision, restent humaines.
En résumé : automatisation massive de l'exécution, autonomie de stratégie émergente, et un plafond visible. La boucle ne se referme pas toute seule.
L'indice HCI : forts en maths, faibles en agents
Pour objectiver ce constat, les auteurs ont construit un indicateur, le Headroom-Closed Index (HCI). L'idée est simple : pour chaque famille de benchmarks, on mesure à quel point le potentiel est déjà « fermé », c'est-à-dire la progression réalisée entre le premier modèle de référence et l'état de l'art actuel. Un HCI de 0 correspond au niveau de l'année d'entrée du benchmark, un HCI de 100 au score parfait. C'est en substance une note de progression : ce qui restait à gagner, et ce qui a été gagné.
Les valeurs 2026 donnent une photographie saisissante :
- Maths avancées : 86,4. L'équivalent d'une note de 86 sur 100 : le potentiel est presque entièrement exploité.
- Sciences niveau master : 85,8.
- Savoir général : 77,2.
- Raisonnement juridique : 64,5.
- Agents outils : 39,9. La plus basse de toutes : un peu moins de 40 sur 100 pour les agents qui doivent utiliser des outils dans des flux de travail réels.
- Agents cybersécurité : 91,9, avec une réserve méthodologique signalée par les auteurs eux-mêmes, les observations tardives de Cybench reposant sur des sous-ensembles de tâches et des agrégations qui changent.
Le paradoxe apparent se lit immédiatement : les IA excellent dans les épreuves fermées, examens, quiz, problèmes de maths avec réponse unique, et restent en retrait dès qu'il faut agir de façon interactive. Pourquoi ? Parce qu'un examen est un environnement stable avec une correction connue, tandis qu'un agent doit planifier, sélectionner des outils, interpréter des résultats, se corriger en cours de route et gérer des erreurs qui se propagent d'étape en étape. Être fort à un test et savoir s'optimiser sont deux compétences différentes, et la seconde est infiniment plus difficile.
L'indice révèle aussi un ralentissement dans plusieurs domaines. En raisonnement juridique, le gain annuel tombe de 48,2 points en 2024 à 11,4 en 2025, puis 4,9 en 2026. Les capacités interactives, agents outils, génie logiciel, recherche et terminal, gardent les plus grands écarts. Autrement dit : les épreuves faciles à noter se referment vite, les compétences d'agent résistent.
Ce tableau a un intérêt direct pour le sujet du papier : les auteurs font le lien entre les faibles scores des agents interactifs et la difficulté de la RSI. Un système qui peine sur les tâches d'agent n'est pas prêt à orchestrer sa propre boucle d'amélioration.
Pourquoi ce cadre compte : enjeux et conséquences
Un lecteur pressé pourrait voir là un exercice académique de plus. Ce serait une erreur, pour trois raisons.
Mesurer l'autonomie d'amélioration, pas seulement la performance. Les classements habituels comparent des scores. La grille du papier compare des responsabilités : qui décide quoi dans la boucle d'amélioration, quels composants restent sous contrôle humain, ce que les successeurs héritent des rounds précédents. C'est une différence de nature, et elle permet de dire précisément où se trouve le curseur pour chaque système.
Anticiper les seuils. Le passage au niveau L3, un système qui choisit sa propre expérience d'apprentissage, puis à L5, un système qui modifie ses propres mécanismes d'amélioration, constituerait un changement qualitatif, pas un progrès incrémental. Disposer d'une échelle commune permet de repérer ces franchissements au lieu de les découvrir dans un communiqué de presse ou, pire, après coup. Ce type de cadre rejoint les préoccupations de sécurité déjà exprimées dans le secteur, comme quand OpenAI a ralenti le développement de ses modèles face aux risques de cybersécurité, ou quand Dario Amodei a appelé l'industrie de l'IA à ralentir avant que les agents ne prennent le contrôle d'Internet.
Éclairer la gouvernance. Le papier identifie des défis précis : vérifier de façon fiable qu'une amélioration est réelle, différencier ce qui relève d'une décision contrôlée par l'IA de ce qui relève d'une procédure fixe, maîtriser les coûts, garantir la sécurité, disposer des bonnes infrastructures. Ce sont exactement les questions que devront trancher les politiques d'évaluation et de gouvernance, à commencer par le maintien d'une autorité humaine sur les déploiements conséquentiels.
Que se passerait-il si un système franchissait réellement les niveaux L3 à L5 ? Les scénarios documentés dans la littérature convergent vers quelques tendances.
- Accélération de la recherche en IA. Une boucle d'amélioration qui se referme raccourcit le cycle entre une découverte et son exploitation. Les gains de productivité observés dès les niveaux L1 et L2 laissent entrevoir l'ampleur du phénomène.
- Dépendance à des systèmes qu'on ne comprend plus. Une IA qui modifie ses propres stratégies, son expérience et ses mécanismes d'amélioration produit des successeurs dont la traçabilité devient un défi technique en soi. Les auteurs insistent sur les mécanismes de retour arrière et de validation indépendante, précisément parce que l'accumulation d'améliorations opaques peut dégrader des capacités antérieures sans qu'on s'en rende compte.
- Questions de sécurité et lien avec le désalignement. Le papier documente des cas concrets où des systèmes exploitent leur évaluateur plutôt que de progresser : les auteurs citent notamment des expériences d'Anthropic, avec une sélection des meilleures graines aléatoires et une tentative d'extraction des réponses de test par requêtes répétées. Quand un système influence ses propres critères de validation, la porte s'ouvre à des comportements qui poursuivent des objectifs internes plutôt que ceux fixés par les humains. C'est le risque classique du désalignement de l'IA, transposé à la boucle d'amélioration : un système qui contrôle ses propres mécanismes de validation peut dériver sans contrepoids.
- Dépendance industrielle. Les laboratoires construisent déjà leurs chaînes de développement sur des agents internes. À mesure que ces outils montent dans les niveaux d'autonomie, la capacité d'un laboratoire à comprendre et vérifier sa propre chaîne de production devient un point de défaillance stratégique.
Le titre du papier est donc moins une prophétie qu'un avertissement : la « dernière IA construite par les humains » est un horizon qui dépendra de choix de conception et de gouvernance, pas une échéance mécanique.
Questions fréquentes
Qu'est-ce que l'amélioration récursive (RSI) ?
C'est un processus autonome en boucle fermée où un système d'IA identifie ses propres limites, développe et valide des améliorations, puis utilise les capacités acquises pour améliorer le processus d'amélioration lui-même. Selon le papier arXiv 2609.11873, aucun système actuel ne l'atteint réellement : les mieux placés restent entre les niveaux 1 et 2 sur une échelle de 5.
Qu'est-ce que l'indice HCI ?
Le Headroom-Closed Index mesure à quel point le potentiel d'un domaine de benchmarks est « fermé », de 0 (niveau du premier modèle de référence) à 100 (score parfait). En 2026, les maths avancées atteignent 86,4 et les sciences niveau master 85,8, tandis que les agents outils plafonnent à 39,9.
Le papier annonce-t-il une IA qui s'améliore toute seule ?
Non. Le titre « The Last AI Built by Humans » exprime une vision à long terme, pas un système existant. L'étude est un cadre de référence qui définit l'amélioration récursive en 5 niveaux d'autonomie et conclut que la RSI authentique n'existe pas encore.
Que se passerait-il si une IA atteignait les niveaux 3 à 5 ?
Le papier identifie des défis majeurs : vérifier de façon fiable les améliorations, distinguer les décisions contrôlées par l'IA des procédures fixes, et garantir la sécurité d'un système qui hérite d'améliorations potentiellement défaillantes. Une IA capable de choisir sa propre expérience d'apprentissage (niveau 3) puis de modifier ses mécanismes d'amélioration (niveau 5) marquerait un changement qualitatif exigeant une gouvernance renforcée.